အောက်တိုဘာလ ၁၆ ရက်။
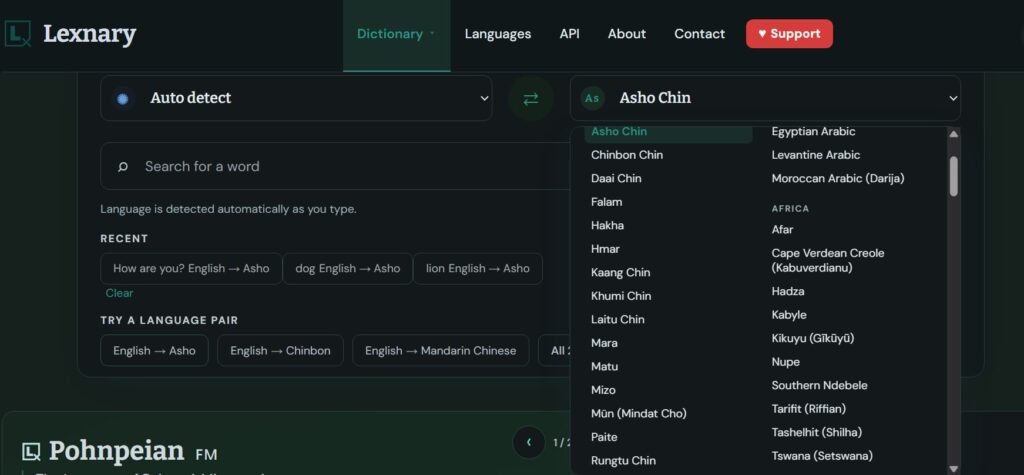
Google Translate မှာ မပါဝင်သေးတဲ့ တိုင်းရင်းသား လူနည်းစု ဘာသာစကားတွေ အပါအဝင် ဘာသာစကားပေါင်း ၂၀၅ မျိုးကို အပြန်အလှန် ရှာဖွေနိုင်မယ့် ‘Lexnary’ အမည်ရှိ အခမဲ့ အဘိဓာန် ပလက်ဖောင်းတစ်ခုကို ကိုယ်တိုင် တည်ဆောက်ပြီး ဇိုမီတို့ရဲ့ ရိုးရာနှစ်သစ်ကူးပွဲတော် (Zomi Khuado Pawi) ကို ဂုဏ်ပြုတဲ့အနေနဲ့ မျှဝေလိုက်တယ်လို့ နည်းပညာဖန်တီးသူ David Mung က ပြောပါတယ်။
Lexnary ကို စမ်းသပ်အသုံးပြုလိုပါက
Facebook Page:
https://www.facebook.com/profile.php?id=61595117946685 တို့မှာ ကြည့်ရူ့
လေ့လာနိုင်ပါတယ်။
အဆိုပါ Lexnary အဘိဓာန်မှာ ဘာသာစကား ၂၀၅ မျိုး ပါဝင်တဲ့အနက် ၁၇၄ မျိုးဟာ Google Translate မှာ ထည့်သွင်းထားခြင်း မရှိသေးတဲ့ ဘာသာစကားတွေ ဖြစ်ပါတယ်။ အဲဒီအထဲမှာ ဇိုမီ (တီးတိန်)၊ မရာ၊ ဖလမ်း၊ ဟားခါး၊ မတူ၊ မီဇို အစရှိတဲ့ ချင်းတိုင်းရင်းသား ဘာသာစကားတွေအပြင် ကချင်၊ ကရင်၊ ရှမ်း၊ မွန် စတဲ့ မြန်မာနိုင်ငံက အခြား တိုင်းရင်းသား ဘာသာစကားတွေ ပါဝင်ပြီး စုစုပေါင်း ဝေါဟာရ စကားလုံးပေါင်း ၁ ဒသမ ၅ သန်း (၁၅ သိန်း) ကျော်ကို ထည့်သွင်း စုစည်းပေးထားတာ ဖြစ်ပါတယ်။
ဒီပလက်ဖောင်းကို ဖန်တီးဖြစ်ခဲ့တဲ့ မူလရည်ရွယ်ချက်နဲ့ ပတ်သက်ပြီး David Mung က “အစတုန်းကတော့ တိုင်းရင်းသား လူနည်းစု ဘာသာစကားတွေကြား ဘယ်ဝါကျကိုမဆို ဘာသာပြန်ပေးနိုင်မယ့် AI model တစ်ခုကို လေ့ကျင့် တည်ဆောက်ချင်ခဲ့တာပါ။ ဒါပေမဲ့ အကြီးမားဆုံး စိန်ခေါ်မှုဟာ နည်းပညာ မဟုတ်ဘဲ အချက်အလက် (Data) ဖြစ်နေတယ်ဆိုတာကို ချက်ချင်း သဘောပေါက်ခဲ့ပါတယ်။ ဇိုမီ (တီးတိန်) လို ဘာသာစကားမျိုးတွေဟာ Google Translate မှာ မပါဝင်သလို၊ ယုံကြည်စိတ်ချရတဲ့ data တွေလည်း အလွန်နည်းပါးပါတယ်။ စကားလုံးတော်တော်များများဟာ အင်္ဂလိပ်စာလုံးတွေနဲ့ တစ်လုံးချင်း တိုက်ရိုက်ကိုက်ညီမှု မရှိကြသလို၊ စနစ်တကျ သင်ယူလေ့လာနိုင်ဖို့အတွက် လက်တွေ့သုံး ဝါကျတွေနဲ့ သဒ္ဒါဆိုင်ရာ နမူနာတွေကလည်း မရှိသလောက် ရှားပါးနေပါတယ်” လို့ ရှင်းပြပါတယ်။
ဒါကြောင့် AI စနစ်ကို တိုက်ရိုက်တည်ဆောက်မယ့်အစား အခြေခံအကျဆုံးဖြစ်တဲ့ ဒေတာအချက်အလက် စုဆောင်းမှုကနေ စတင်ခဲ့ရပုံကိုလည်း သူက အခုလို ဆက်ပြောပါတယ်။
“ဒါကြောင့် အခြေခံအုတ်မြစ်ဖြစ်တဲ့ အဘိဓာန်ကနေပဲ စတင်ဖို့ ကျွန်တော် ဆုံးဖြတ်ခဲ့ပါတယ်။ ပထမဦးစွာ စကားလုံးတွေကို တစ်စုတစ်စည်းတည်း စုစည်းပြီး အဲဒီဘာသာစကားကို ပြောဆိုကြတဲ့ ဒေသခံတွေကိုယ်တိုင် စစ်ဆေး အတည်ပြုစေတာပါ။ အချက်အလက်တွေကို စစ်ဆေးပြီး လုံလောက်အောင် ပြည့်စုံကြွယ်ဝလာပြီဆိုမှသာ အဲဒီအပေါ်မှာ အခြေခံပြီး ဘာသာပြန် model တစ်ခုကို လေ့ကျင့် တည်ဆောက်သွားနိုင်မှာ ဖြစ်ပါတယ်” လို့ ဆိုပါတယ်။
Lexnary အဘိဓာန်ရဲ့ ထူးခြားချက်မှာ အဘိဓာန်အများစုကဲ့သို့ တစ်ဖက်သတ် ရှာဖွေမှုမျိုး မဟုတ်ဘဲ မိမိရှာလိုသည့် ဘာသာစကား နှစ်ဖက်စလုံးကနေ အပြန်အလှန် ရှာဖွေနိုင်ခြင်း ဖြစ်ပါတယ်။ ဥပမာအားဖြင့် English မှ Zomi သို့မဟုတ် Zomi မှ German သို့ ပြန်လှန်ရှာဖွေနိုင်သလို နေ့စဉ်သုံး စကားလုံးများနှင့် အခြေခံ စကားပြောများကိုပါ ထည့်သွင်းထားပါတယ်။
ဇိုမီဘာသာစကားကနေ အခြားသော တိုင်းရင်းသား ဘာသာစကားတွေဆီ ကူးပြောင်းချဲ့ထွင်ခဲ့တဲ့ အခြေအနေနဲ့ ပတ်သက်လို့လည်း David Mung က “ဇိုမီ အဘိဓာန်ကို တည်ဆောက်နေတဲ့အချိန်မှာပဲ Google Translate က ချန်လှပ်ထားခဲ့တဲ့ ဘာသာစကားတိုင်းအတွက် ဘာလို့ ဒီလိုမျိုး မလုပ်ပေးနိုင်ရမှာလဲလို့ ကိုယ့်ကိုယ်ကိုယ် မေးခွန်းထုတ်မိခဲ့ပါတယ်။ အဲဒီလို လုပ်ပေးလိုက်နိုင်ရင် သက်ဆိုင်ရာ ဘာသာစကားအားလုံးဟာ သူတို့ရဲ့ စကားလုံးတွေကို တစ်နေရာတည်းမှာ သိမ်းဆည်းထားနိုင်မယ့် နေရာတစ်ခု ရှိလာမှာဖြစ်ပြီး ကိုယ်တိုင်ပြောဆိုတဲ့ ဒေသခံတွေကိုယ်တိုင်က ပြန်လည် ပြင်ဆင်တည်းဖြတ်နိုင်မှာ ဖြစ်ပါတယ်။
ဒါ့အပြင် အဘိဓာန် အများစုမှာ မရနိုင်တဲ့ နှစ်ဖက်စလုံး အပြန်အလှန် ရှာဖွေနိုင်တဲ့ စနစ်မျိုးကိုလည်း ကျွန်တော် ဖြစ်စေချင်ခဲ့ပါတယ်။ ဥပမာအားဖြင့် English ကနေ Zomi စကားလုံးစာရင်းကို ရှာတွေ့နိုင်ပေမဲ့ Zomi စကားလုံးတစ်လုံးရဲ့ အဓိပ္ပာယ်ကို ပြန်ရှာဖို့ကျတော့ အများကြီး ပိုခက်ခဲသလို၊ တခြား ဘာသာစကား အများစုမှာလည်း ဒီအတိုင်းပါပဲ။ Lexnary မှာတော့ ကိုယ့်ရဲ့ မိခင်ဘာသာစကားနဲ့ ရိုက်ထည့်ရှာဖွေနိုင်သလို အင်္ဂလိပ်၊ ဂျပန်၊ ကိုရီးယား ဒါမှမဟုတ် မလေးရှား စတဲ့ ဝဘ်ဆိုက်ထဲမှာရှိတဲ့ တခြား ဘယ်ဘာသာစကားနဲ့မဆို အပြန်အလှန် ရှာတွေ့နိုင်မှာ ဖြစ်ပါတယ်” လို့ ထည့်သွင်း ပြောဆိုပါတယ်။
Lexnary စမ်းသပ်အသုံးပြုသူတစ်ဦးက ” အဲဒီဟာကိုစမ်းသုံးရင်းသတိထားမိတာကတော့ ကျတော်တို့ချင်းလူမျိုးတွေရဲ့ တူညီတဲ့ေ၀◌ါဟာရတွေကဘာတွေလဲဆိုတာကို အလွယ်တကူရှာကြည့် လို့ရတယ်။ အဲဒါကတော့ ကျတော်တို့ ဘာသာစကားကွဲတယ်လို့ ပြောကြတဲ့ ချင်းတွေအတွက် အဓိကအားသာချက်လို့ပြောလို့ရမယ်။ ဘယ်ချင်းဒေသကစကားနဲ့ ဘယ်အရာကို ဘယ်လိုခေါ်သလဲဆိုတာမျိုးကို ချက်ခြင်းရှာဖွေသိရှိနိုင် တာဖြစ်တယ်။ အဲဒီစကားလုံးကိုပဲ တစ်ခြားတိုင်းရင်းသား၊ နိုင်ငံခြားဘာသာစကားတွေနဲ့ အပြန်အလှန်ရှာလို့ရတွေ့ရ တယ်” လို့ပြောပါတယ်။
လက်ရှိ Lexnary ပလက်ဖောင်းပေါ်ရှိ စကားလုံးအချက်အလက် အများအပြားကို လူကိုယ်တိုင် စစ်ဆေးအတည်ပြုရခြင်း မရှိသေးတာကြောင့် သက်ဆိုင်ရာ ဘာသာစကား ပြောဆိုသူများအနေနဲ့ စကားလုံးအမှားအယွင်းများ တွေ့ရှိပါက ပြင်ဆင်ရန် အကြံပြုပေးပို့နိုင်သလို၊ လုပ်အားပေး အယ်ဒီတာ (Volunteer Editor) အဖြစ်လည်း ပါဝင်ကူညီကြဖို့ ဖိတ်ခေါ်ထားတယ်လို့ သိရပါတယ်။